TasteVal چیست؟ وقتی Claude در طراحی آزمایش از متخصصها جلو زد
در بنچمارک تازهی TasteVal، مدل Claude Opus 5.5 در انتخاب و تفسیر آزمایشهای پژوهشی از ۲۴ متخصص انسانی بهتر عمل کرد، آن هم با حدود یکسیام هزینه. یعنی چه و کجا به کار شما میآید؟
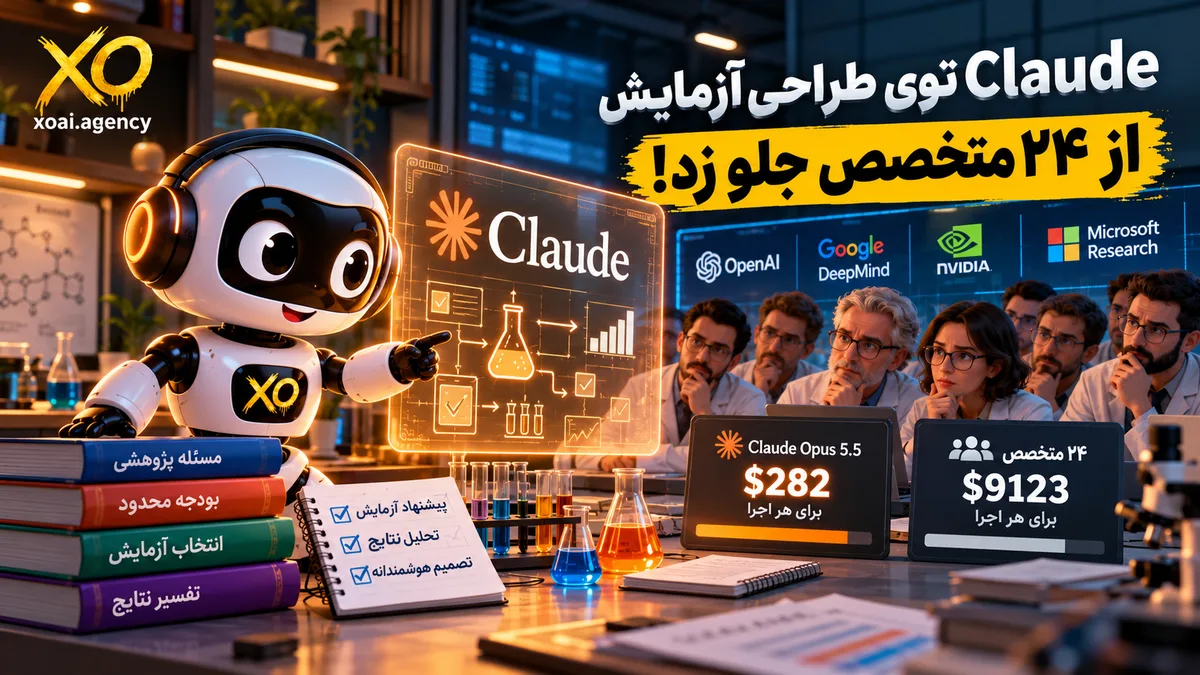
«TasteVal» چیست و چرا اسمش این هفته همهجا پیچیده است؟ TasteVal یک بنچمارک تازه است که نه سرعت کدنویسی، بلکه «سلیقهی تحقیقاتی» هوش مصنوعی را میسنجد؛ یعنی اینکه مدل چقدر خوب تصمیم میگیرد کدام آزمایش را اول انجام بدهد، نتیجه را چطور بخواند و قدم بعدی را چطور انتخاب کند. در مقالهی TasteVal در arXiv که اوایل اکتبر ۲۰۲۶ منتشر شد، مدل Claude Opus 5.5 از خط پایهی ۲۴ متخصص انسانی جلوتر رفت، آن هم با حدود یکسیام هزینه.
خلاصهی این خبر را همان روز اول در کانال تلگرام XO گذاشتیم. اگر با مدلهای Claude آشنا نیستید، اول Claude Opus 5.5 چیست را بخوانید.
TasteVal دقیقاً چه چیزی را میسنجد؟
بیشتر بنچمارکهایی که میشنوید، میپرسند مدل چقدر درست کد مینویسد یا به سؤال جواب میدهد. TasteVal سؤال دیگری دارد: اگر یک مسئلهی پژوهشی باز و یک بودجهی محدود به مدل بدهید، چقدر هوشمندانه آن بودجه را خرج آزمایشهای درست میکند؟
این همان چیزی است که در دنیای پژوهش به آن «سلیقه» یا taste میگویند. دو پژوهشگر با مهارت فنی برابر، میتوانند نتیجههای خیلی متفاوتی بگیرند، فقط به این خاطر که یکی میداند کدام آزمایش ارزش انجام دارد و دیگری وقتش را روی مسیرهای بینتیجه میگذارد.
آزمون چطور طراحی شده است؟
طراحی TasteVal یک ترفند جالب دارد که آن را از بقیه جدا میکند. مدلی که سنجیده میشود، نقش «پژوهشگر» را دارد و فقط آزمایش پیشنهاد میدهد و نتیجه را تفسیر میکند. خودش هیچ کدی نمینویسد و اجرا نمیکند. کدنویسی را یک ایجنت ثابت به اسم «کدنویس» انجام میدهد که در همهی آزمونها یکی است و طبق مقاله، Opus 4.8 است.
این جداسازی یعنی مهارت کدنویسی از معادله بیرون میرود و فقط کیفیت تصمیمها سنجیده میشود. هر اجرا بودجهی ۴۰ ساعت پردازندهی H100 یا ۱۲۰ ساعت زمان واقعی دارد و مدل فقط امتیاز اعتبارسنجی را میبیند، نه امتیاز نهایی.
بنچمارک هشت مسئلهی باز در حوزهی پژوهش هوش مصنوعی دارد؛ از انتخاب داده برای آموزش مدل تا مدلسازی ترجیحات انسانی. نویسندهها جزئیات مسئلهها را عمداً منتشر نکردهاند تا مدلها نتوانند از قبل جوابشان را ببینند.
متخصصهای انسانی چه کسانی بودند؟
خط پایهی انسانی از ۲۴ متخصص ساخته شده، حداقل دو نفر برای هر مسئله. طبق مقاله، این افراد سابقهی کار اخیر در جاهایی مثل OpenAI، Google DeepMind، NVIDIA، Microsoft Research و دانشگاه آکسفورد داشتند. هر کدام قبل از شروع، ۴ تا ۱۶ ساعت مطالعهی منابع انجام دادند و برای هر مسئله، بهترین تلاش انسانی بهعنوان خط پایه انتخاب شد.
یعنی Claude با میانگین آدمها مقایسه نشده؛ با بهترین نتیجهی متخصصهایی مقایسه شده که کارشان همین است.
نتیجهی Claude Opus 5.5 در TasteVal
معیار اصلی TasteVal چیزی است به اسم «ضریب محاسبه». اگر مدلی با نصف بودجهی آزمایش به همان امتیاز متخصص برسد، ضریبش ۲ است. Opus 5.5 ضریب ۲.۳ گرفت؛ یعنی بهطور میانگین با کمتر از نصف بودجهی آزمایش، به سطح بهترین متخصص رسید.
مقایسهی هزینه هم جالب است. طبق مقاله، هر اجرای Opus 5.5 بهطور میانگین ۲۸۲ دلار هزینه داشت (API بهعلاوهی پردازنده)، در حالی که هر اجرای متخصص انسانی با حساب دستمزد حدود ۹۱۲۳ دلار تمام شد. Claude Fable 5.1 هم ضریب ۱.۶۸ گرفت و برای مقایسه، GPT-4 روی همین معیار حدود ۰.۰۳ بوده است.
یک نکته که خیلیها ندیدند
تیتر «هوش مصنوعی از متخصصها جلو زد» جذاب است، ولی خود نویسندههای TasteVal چند محدودیت مهم را صریح نوشتهاند که در بیشتر خبرها گم شده است.
اول، مسئلهها عمداً طوری انتخاب شدهاند که نتیجه سریع و دقیق قابل سنجش باشد. پژوهش واقعی معمولاً اینقدر تمیز نیست. دوم، طبق مقاله، بیشتر پیشرفت مدلها از بهینهسازی سطحی و متوسط آمده، نه از ایدههای واقعاً نو. سوم، بنچمارک انتخاب خود مسئله را نمیسنجد؛ یعنی اینکه اصلاً روی چه چیزی باید کار کرد، هنوز کار آدم است.
نکتهی آخر هم اینکه Opus 5.5 و Fable 5.1 یکی از هشت مسئله را رد کردند و فقط روی هفت مسئله سنجیده شدند. پس عددها را باید با همین قید خواند.
چرا این خبر در دنیای هوش مصنوعی سر و صدا کرد؟
دلیل اصلی، سرعت پیشرفت است. طبق مقاله، ضریب TasteVal مدلهای پیشرو از دسامبر ۲۰۲۵ تقریباً هر سه ماه دو برابر شده، در حالی که قبل از آن هر ۱۴ ماه یک بار دو برابر میشد.
جک کلارک، از همبنیانگذاران Anthropic، در شمارهی ۴۷۶ خبرنامهی Import AI به همین نتیجه اشاره کرده و نوشته که برآوردش از زمانبندی پیشرفت پژوهش خودکار با هوش مصنوعی را یک سال جلو کشیده است. این یک برداشت شخصی است، ولی نشان میدهد این بنچمارک برای خود سازندههای مدل هم معنادار بوده است.
TasteVal برای کسبوکار ایرانی چه معنایی دارد؟
شاید بگویید من پژوهشگر هوش مصنوعی نیستم، این خبر چه ربطی به من دارد؟ ربطش این است: مهارتی که TasteVal میسنجد، یعنی انتخاب آزمایش درست با بودجهی محدود، دقیقاً همان مهارتی است که هر کسبوکاری لازم دارد.
چند مثال واقعی:
- صاحب فروشگاه اینترنتی که نمیداند اول قیمت را تست کند یا عکس محصول یا متن صفحه را.
- تولیدکنندهی محتوا که بین چند فرمت ریلز مانده و نمیداند کدام تست ارزش وقت گذاشتن دارد.
- تیم تبلیغات که بودجهی محدودی دارد و باید بین چند کمپین آزمایشی انتخاب کند.
در همهی اینها میتوانید از Claude بخواهید نقش طراح آزمایش را بازی کند: «این سه گزینه را دارم، بودجهام اینقدر است، کدام تست را اول انجام بدهم و چطور نتیجه را بسنجم؟» یاد گرفتن نوشتن چنین درخواستی، بخشی از مهندسی پرامپت است.
از کجا شروع کنم؟
۱. یک تصمیم واقعی که این هفته باید بگیرید را انتخاب کنید؛ مثلاً دو نسخهی تبلیغ یا دو قیمت.
۲. از Claude بخواهید قبل از هر پیشنهادی، سه آزمایش کوچک و ارزان طراحی کند و بگوید هر کدام چه چیزی را ثابت یا رد میکند.
۳. نتیجهی هر تست را دوباره به Claude بدهید و از او بخواهید قدم بعدی را پیشنهاد کند.
۴. تصمیم نهایی را خودتان بگیرید. همانطور که خود TasteVal نشان داد، انتخاب اینکه اصلاً روی چه مسئلهای کار کنید، هنوز کار شماست.
اگر بین Claude و رقبا مردد هستید، کلاد یا چت جی پی تی را هم ببینید.
سوالات متداول
TasteVal را چه کسی ساخته است؟
TasteVal را دو پژوهشگر به نامهای Oliver Jaffe و Dane Sherburn از گروه P-Zero Research ساختهاند و مقالهاش در arXiv منتشر شده است. این بنچمارک ساخت Anthropic نیست و مستقل از سازندههای مدل طراحی شده است.
یعنی Claude از پژوهشگرهای انسانی بهتر است؟
فقط در همین آزمون مشخص و با قیدهایش. مسئلهها سریع و تمیز قابل سنجش بودند، پیشرفت بیشتر از بهینهسازی آمد نه ایدهی نو، و انتخاب مسئله سنجیده نشد. نتیجه میگوید Claude در طراحی و تفسیر آزمایش خیلی قوی شده، نه اینکه جای پژوهشگر را بگیرد.
برای استفاده از این قابلیت چه پلنی لازم است؟
TasteVal یک آزمون است، نه یک قابلیت جدید. ولی مدل Opus 5.5 که در آن اول شد، همین حالا داخل Claude قابل استفاده است. برای اینکه ببینید کدام پلن به کار شما میآید، اشتراک کلاد در ایران را بخوانید.
مقالات مرتبط
قدم بعدی
- اگر میخواهید تصمیمها و تستهای کسبوکارتان با کمک ایجنتها سریعتر جلو برود، از صفحهی مشاوره XO درخواست بدهید.
- برای یاد گرفتن اصولی کار با Claude، فصلهای دورهی سفر هوش مصنوعی را ببینید.
- خبرهای روز هوش مصنوعی را کوتاه و کاربردی در کانال تلگرام XO دنبال کنید.
میخواهی اینها را عملی یاد بگیری؟
دورهی سفر هوش مصنوعی: ۷ فصل پروژهمحور از صفر تا درآمد.
نظرها